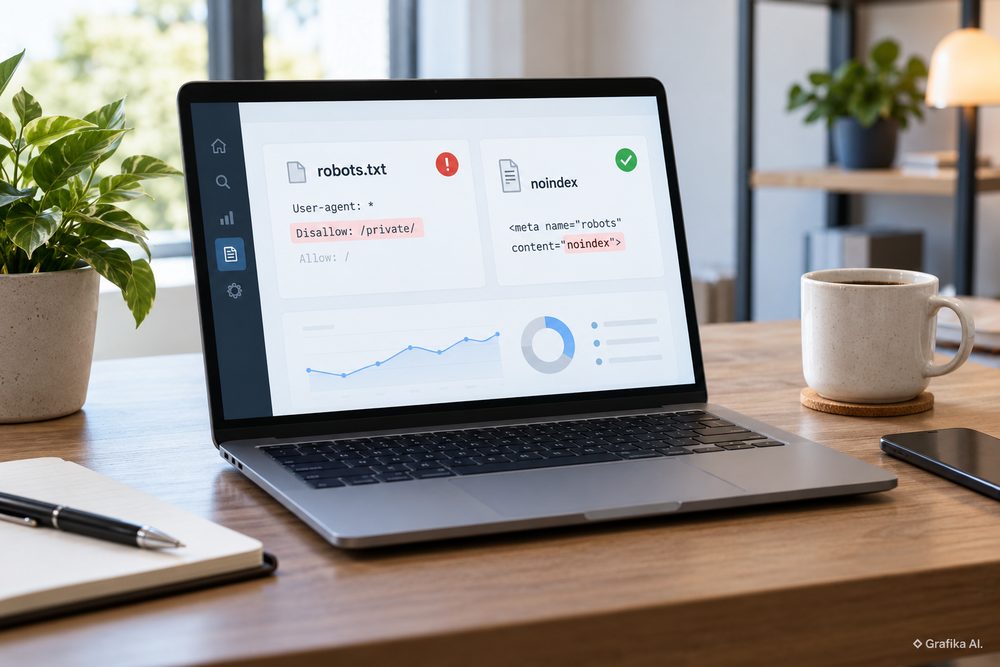
Strona działa, odpowiada kodem 200, znajduje się w mapie witryny, a mimo to nie pojawia się w Google. Przyczyną bywa pojedyncza dyrektywa Disallow w pliku robots.txt albo pozostawiony po testach znacznik noindex. Problem robi się poważniejszy, gdy oba mechanizmy działają jednocześnie. Właściciel strony zakłada, że podwójna blokada zapewnia większą kontrolę, tymczasem Googlebot może nie mieć możliwości odczytania instrukcji, która miała wykluczyć adres z wyników wyszukiwania.
Robots.txt kontroluje dostęp robotów do adresów URL, a noindex decyduje o możliwości umieszczenia strony w indeksie. To dwa różne etapy działania wyszukiwarki. Ich pomylenie może prowadzić zarówno do przypadkowego wykluczenia ważnych podstron, jak i pozostawienia niechcianych adresów w wynikach Google.
Robots.txt i noindex – dwa mechanizmy, których nie wolno traktować zamiennie
Plik robots.txt znajduje się w katalogu głównym hosta, przykładowo pod adresem https://sklep.pl/robots.txt. Zawiera instrukcje określające, które zasoby robot wyszukiwarki może pobierać. Reguły dotyczą konkretnego protokołu, hosta i portu, dlatego ustawienia dla https://sklep.pl nie muszą automatycznie obowiązywać w subdomenie blog.sklep.pl.
Przykładowa konfiguracja:
User-agent: *
Disallow: /koszyk/
Disallow: /konto/
Oznacza, że roboty respektujące te instrukcje nie powinny pobierać adresów rozpoczynających się od wskazanych ścieżek. Nie oznacza jednak, że wszystkie takie adresy znikną z Google.
Jeżeli do zablokowanego URL prowadzą linki z innych witryn, wyszukiwarka może znać jego adres i wyświetlić go w wynikach bez normalnego opisu zawartości. Blokada indeksowania nie jest więc automatyczną konsekwencją zablokowania crawlowania.
Inaczej działa noindex, umieszczany w sekcji <head> dokumentu HTML:
<meta name="robots" content="noindex">Po odczytaniu tej dyrektywy Google usuwa dany dokument ze swojego indeksu lub nie dopuszcza do jego indeksacji. Warunek jest zasadniczy: Googlebot musi móc pobrać stronę i zobaczyć znacznik.
Dla plików innych niż HTML, między innymi PDF, stosuje się także nagłówek odpowiedzi HTTP:
X-Robots-Tag: noindexW praktyce wybór rozwiązania zależy od celu:
- Robots.txt ma sens przy ograniczaniu pobierania dużej liczby nieistotnych adresów, np. niektórych kombinacji filtrów i parametrów w sklepach internetowych.
- Noindex sprawdza się przy publicznie dostępnych stronach, które użytkownik może odwiedzić, ale które nie powinny występować w wynikach wyszukiwania.
- Zabezpieczenie hasłem lub kontrola dostępu jest właściwe dla poufnych dokumentów, paneli klientów i danych osobowych. Ani robots.txt, ani noindex nie stanowią zabezpieczenia przed nieuprawnionym dostępem.
Dobrym przykładem jest sklep internetowy oparty na WooCommerce. Strony koszyka i konta klienta nie muszą pozyskiwać ruchu organicznego. Można ograniczać ich crawlowanie, ale jeśli konkretny adres ma zostać usunięty z wyników, samo Disallow nie daje takiej gwarancji. Ponadto dostęp do konta musi być chroniony mechanizmem logowania, niezależnie od ustawień SEO.
Z kolei blokowanie całego katalogu /wp-content/ jest ryzykowne. Google może utracić dostęp do arkuszy CSS, skryptów JavaScript lub obrazów potrzebnych do prawidłowego renderowania witryny. Ograniczenie pobierania zasobów pomocniczych ma sens tylko wtedy, gdy nie utrudnia wyszukiwarce zrozumienia strony.
Dlaczego jednoczesne Disallow i noindex potrafią wywołać problem z indeksowaniem?
Najbardziej problematyczna konfiguracja wygląda następująco: w pliku robots.txt znajduje się zakaz pobierania określonego katalogu, a na stronach w tym katalogu ustawiono noindex.
Przykład:
User-agent: *
Disallow: /promocje/
Jednocześnie dokument https://sklep.pl/promocje/letnia-wyprzedaz/ zawiera:
<meta name="robots" content="noindex">Na pierwszy rzut oka ustawienia wyglądają poprawnie. W rzeczywistości Googlebot respektujący Disallow nie pobierze dokumentu, więc nie odczyta umieszczonego w nim noindex.
Jeżeli adres był wcześniej indeksowany albo prowadzą do niego linki, może nadal występować w wynikach wyszukiwania. Nie oznacza to awarii Google. To konsekwencja sprzecznych z praktycznego punktu widzenia instrukcji.
Przy podejmowaniu decyzji trzeba rozróżnić trzy sytuacje.
Pierwsza: strona ma zostać usunięta z wyników Google. Należy umożliwić robotowi pobranie dokumentu i zastosować noindex. Po ponownym odwiedzeniu strony wyszukiwarka będzie mogła odczytać dyrektywę. Nie ma jednak gwarantowanego terminu usunięcia. W zależności od częstotliwości crawlowania aktualizacja może nastąpić po kilku dniach, tygodniach, a przy rzadko odwiedzanych adresach nawet po miesiącach.
Druga: strona powinna być widoczna w Google. Trzeba usunąć zarówno przypadkowe noindex, jak i blokujące ją reguły robots.txt. Samo usunięcie jednej przeszkody nie wystarczy, jeżeli druga pozostaje aktywna.
Trzecia: witryna generuje tysiące nieprzydatnych wariantów adresów. Przykładem jest sklep z 20 tysiącami produktów, w którym filtry ceny, rozmiaru, marki i sortowania tworzą setki tysięcy kombinacji URL. W takim przypadku kontrola crawlowania ma większe znaczenie operacyjne niż w małej witrynie firmowej.
Nie należy jednak automatycznie blokować wszystkich adresów z parametrami. Niektóre strony filtrowania, takie jak kategoria obejmująca konkretną markę i typ produktu, mogą odpowiadać na rzeczywiste zapytania klientów i zasługiwać na indeksację.
Dodatkowym problemem jest canonical. Wskazanie adresu kanonicznego nie jest odpowiednikiem noindex ani bezwzględnym poleceniem dla Google. To sygnał pomagający wybrać reprezentatywny URL spośród podobnych dokumentów. Jeżeli robot nie może pobrać strony z powodu robots.txt, nie zobaczy umieszczonego w jej kodzie znacznika canonical.
Dlatego dla zbliżonych stron produktowych lub wariantów adresów decyzję należy oprzeć na ich zawartości i przeznaczeniu. Jeśli strony są duplikatami, często właściwsza będzie prawidłowa kanonikalizacja lub przekierowanie. Jeśli dokument ma pozostać dostępny użytkownikom, ale nie powinien znaleźć się w indeksie, odpowiedni będzie noindex. Jeśli problemem jest masowe pobieranie bezwartościowych kombinacji, można rozważyć robots.txt, akceptując ograniczenia tej metody.
Najgorszym rozwiązaniem jest dodawanie wszystkich trzech mechanizmów jednocześnie bez ustalenia, jaki rezultat ma osiągnąć konkretny URL.
Jak sprawdzić robots.txt i noindex oraz bezpiecznie naprawić błędy?
Kontrolę warto rozpocząć od Google Search Console, ponieważ pokazuje problemy wykryte przez Google, a nie tylko konfigurację widoczną w przeglądarce. Przy większych witrynach przydają się również Screaming Frog SEO Spider, logi serwera i możliwość sprawdzenia nagłówków HTTP.
Praktyczna procedura wygląda następująco:
- Sprawdź konkretny URL w Google Search Console. Otwórz narzędzie Sprawdzenie adresu URL i ustal, czy strona jest zaindeksowana, czy robot może ją pobrać oraz jakie ograniczenia wykryto. Rozróżnij dane z ostatniego indeksowania od wyniku bieżącego testu.
- Otwórz plik robots.txt. Sprawdź reguły
User-agent,DisallowiAllow, uwzględniając kolejność dopasowań i długość pasujących ścieżek zgodnie z zasadami Google. Samo znalezienie tekstuDisallownie przesądza jeszcze, że dany adres jest zablokowany. - Zweryfikuj noindex. Sprawdź źródłowy HTML, zwłaszcza sekcję
<head>, a także nagłówki HTTP. Dyrektywa może pochodzić z CMS, wtyczki SEO, konfiguracji serwera lub warstwy CDN. - Sprawdź odpowiedź serwera. Dla aktywnej, publicznej strony przeznaczonej do indeksacji oczekuj zwykle kodu
200. Kod404,410, przekierowanie301lub blokada dostępu mogą całkowicie zmienić sposób obsługi adresu przez wyszukiwarkę. - Wprowadź jedną uzasadnioną zmianę i wykonaj ponowny test. Najpierw usuń rzeczywistą przyczynę problemu, następnie sprawdź bieżącą dostępność URL. Dopiero po potwierdzeniu poprawnej konfiguracji poproś Google o ponowne zindeksowanie ważnej strony.
Weryfikację nagłówków można wykonać poleceniem:
curl -I https://sklep.pl/oferta/Wynik pozwala odczytać kod odpowiedzi i ewentualny nagłówek X-Robots-Tag. To szybka kontrola, ale nie pełny audyt. Polecenie wykorzystuje żądanie HEAD, którego obsługa na niektórych serwerach różni się od standardowego GET. Nie pokazuje też znacznika meta w treści HTML. Przy rozbieżnościach trzeba sprawdzić rzeczywistą odpowiedź GET i wersję dokumentu dostępną dla Googlebota.
Szczególnie często błędy pojawiają się po migracji strony z wersji testowej na produkcyjną. Przykładowo agencja przygotowuje nowy serwis WordPress pod adresem technicznym i włącza opcję zniechęcającą wyszukiwarki do indeksowania. Po przeniesieniu witryny na właściwą domenę ustawienie pozostaje aktywne.
Efekt? Strona główna i podstrony usługowe odpowiadają kodem 200, ale w HTML nadal znajduje się noindex. W przypadku serwisu oferującego lokalne usługi w Warszawie, Krakowie czy Wrocławiu oznacza to utratę możliwości pozyskiwania klientów przez organiczne wyniki wyszukiwania, dopóki problem nie zostanie naprawiony i Google nie przetworzy zmian.
Przy takiej migracji priorytetem jest sprawdzenie strony głównej, głównych kategorii, podstron usługowych i najważniejszych artykułów. Dopiero później warto analizować archiwa, tagi i mniej istotne adresy techniczne.
Trzeba też uwzględnić ograniczenia narzędzi. Screaming Frog w standardowej konfiguracji respektuje robots.txt, dlatego nie zawsze pokaże znaczniki noindex na adresach, których pobieranie jest zabronione. Zmiana ustawień crawlowania może pomóc w diagnostyce własnej witryny, ale nie odzwierciedla wtedy dokładnie zachowania Googlebota.
Po naprawie błędów nie należy mechanicznie żądać indeksacji tysięcy adresów. W przypadku dużych serwisów lepszym rozwiązaniem jest aktualizacja mapy XML, prawidłowe linkowanie wewnętrzne oraz kontrola raportów indeksowania. Mapa witryny powinna wskazywać przede wszystkim kanoniczne adresy przeznaczone do indeksowania, a nie strony celowo objęte noindex.
Podobne zagadnienia związane z technicznym SEO, publikacją treści i widocznością serwisów można analizować również w kontekście planowania działań content marketingowych. Sama poprawna konfiguracja robots.txt nie zapewni wysokich pozycji, jeżeli ważne podstrony mają słabą zawartość, są duplikatami lub pozostają odcięte od linkowania wewnętrznego.
Najważniejsza decyzja przy naprawie: jeżeli adres ma zniknąć z wyników Google, a jednocześnie jest objęty Disallow i noindex, najpierw usuń blokadę crawlowania, zachowując noindex. Jeżeli adres ma wrócić do wyszukiwarki, usuń obie przeszkody i sprawdź pozostałe sygnały indeksowania. Nie wykonuj tych zmian globalnie bez kontroli ścieżek, ponieważ odblokowanie katalogu z tysiącami niepotrzebnych adresów może zwiększyć liczbę żądań Googlebota.
FAQ – najczęstsze pytania o robots.txt i noindex
Czy strona zablokowana w robots.txt może pojawić się w Google?
Tak. Google może znać adres dzięki linkom zewnętrznym lub wewnętrznym i pokazać go w wynikach bez pobierania zawartości. Samo Disallow nie gwarantuje wykluczenia URL z indeksu.
Czy noindex działa, jeśli strona jest zablokowana w robots.txt?
Nie można liczyć na jego skuteczne odczytanie. Jeżeli Googlebot nie może pobrać dokumentu, nie zobaczy znacznika noindex w HTML ani nagłówka odpowiedzi HTTP.
Czy można umieścić noindex bezpośrednio w robots.txt?
Nie. Google nie obsługuje dyrektywy noindex w pliku robots.txt. Należy zastosować znacznik meta robots albo nagłówek HTTP X-Robots-Tag.
Ile trwa usunięcie strony z Google po dodaniu noindex?
Nie ma stałego terminu. Google musi ponownie pobrać adres. Może to potrwać od kilku dni do wielu tygodni, a w niektórych przypadkach dłużej. Przy pilnym usuwaniu wyników można skorzystać z narzędzia Usunięcia w Google Search Console, pamiętając, że jest to rozwiązanie tymczasowe i nie zastępuje trwałej zmiany konfiguracji.
Czy noindex usuwa stronę z internetu?
Nie. Dokument nadal może być dostępny po wpisaniu adresu lub kliknięciu linku. Noindex dotyczy indeksowania w wyszukiwarkach respektujących tę dyrektywę, a nie fizycznej dostępności zasobu.
Czy usunięcie noindex gwarantuje powrót do wyników Google?
Nie. Pozwala usunąć jedną z przeszkód, ale Google nadal ocenia między innymi jakość, duplikację i kanoniczność strony. Trzeba też sprawdzić odpowiedź HTTP, linkowanie oraz dostępność dla robota.
Co należy sprawdzić jako pierwsze, gdy strona nagle znika z wyników?
Najpierw konkretny adres w Google Search Console, potem robots.txt oraz dyrektywy noindex w HTML i nagłówkach HTTP. Jeżeli zniknęło wiele ważnych podstron jednocześnie, rozpocznij od globalnych reguł i zmian wdrożonych na serwerze lub w CMS.
Więcej informacji na: https://cmpress.pl